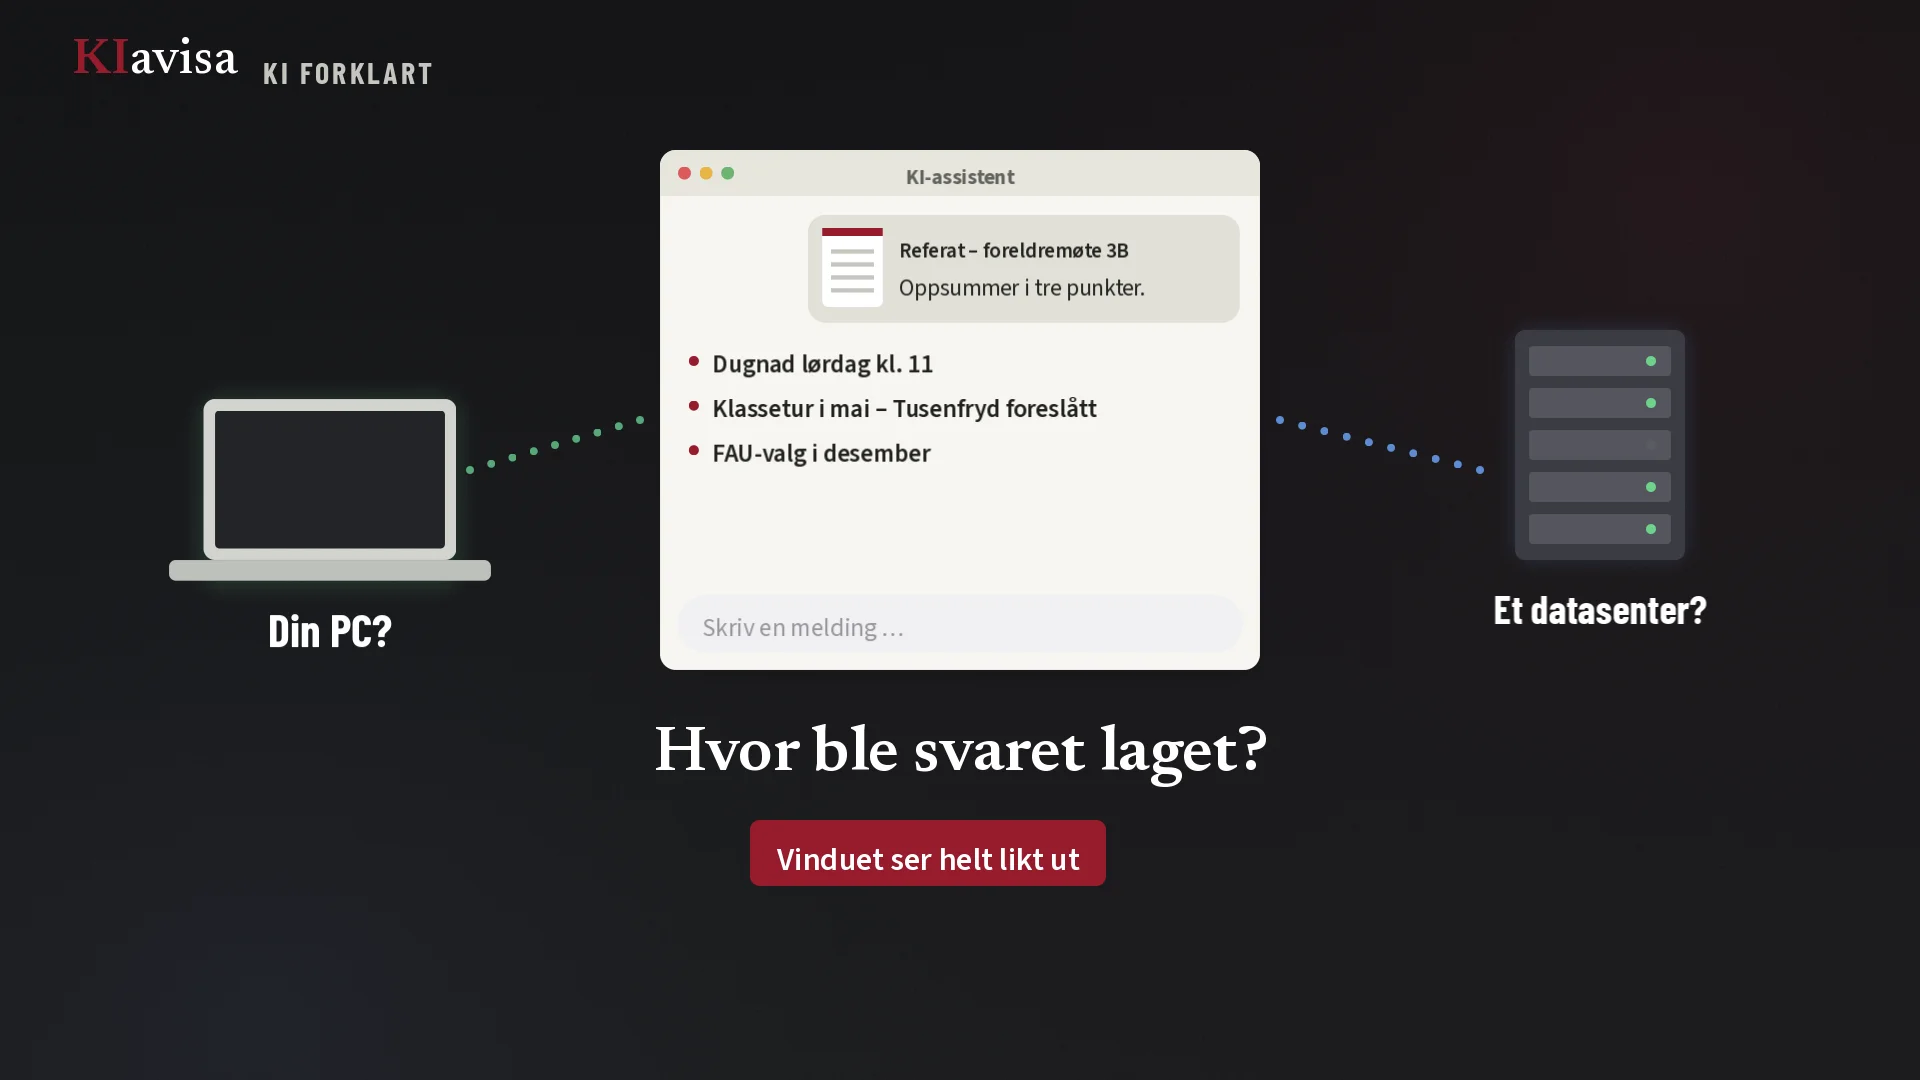
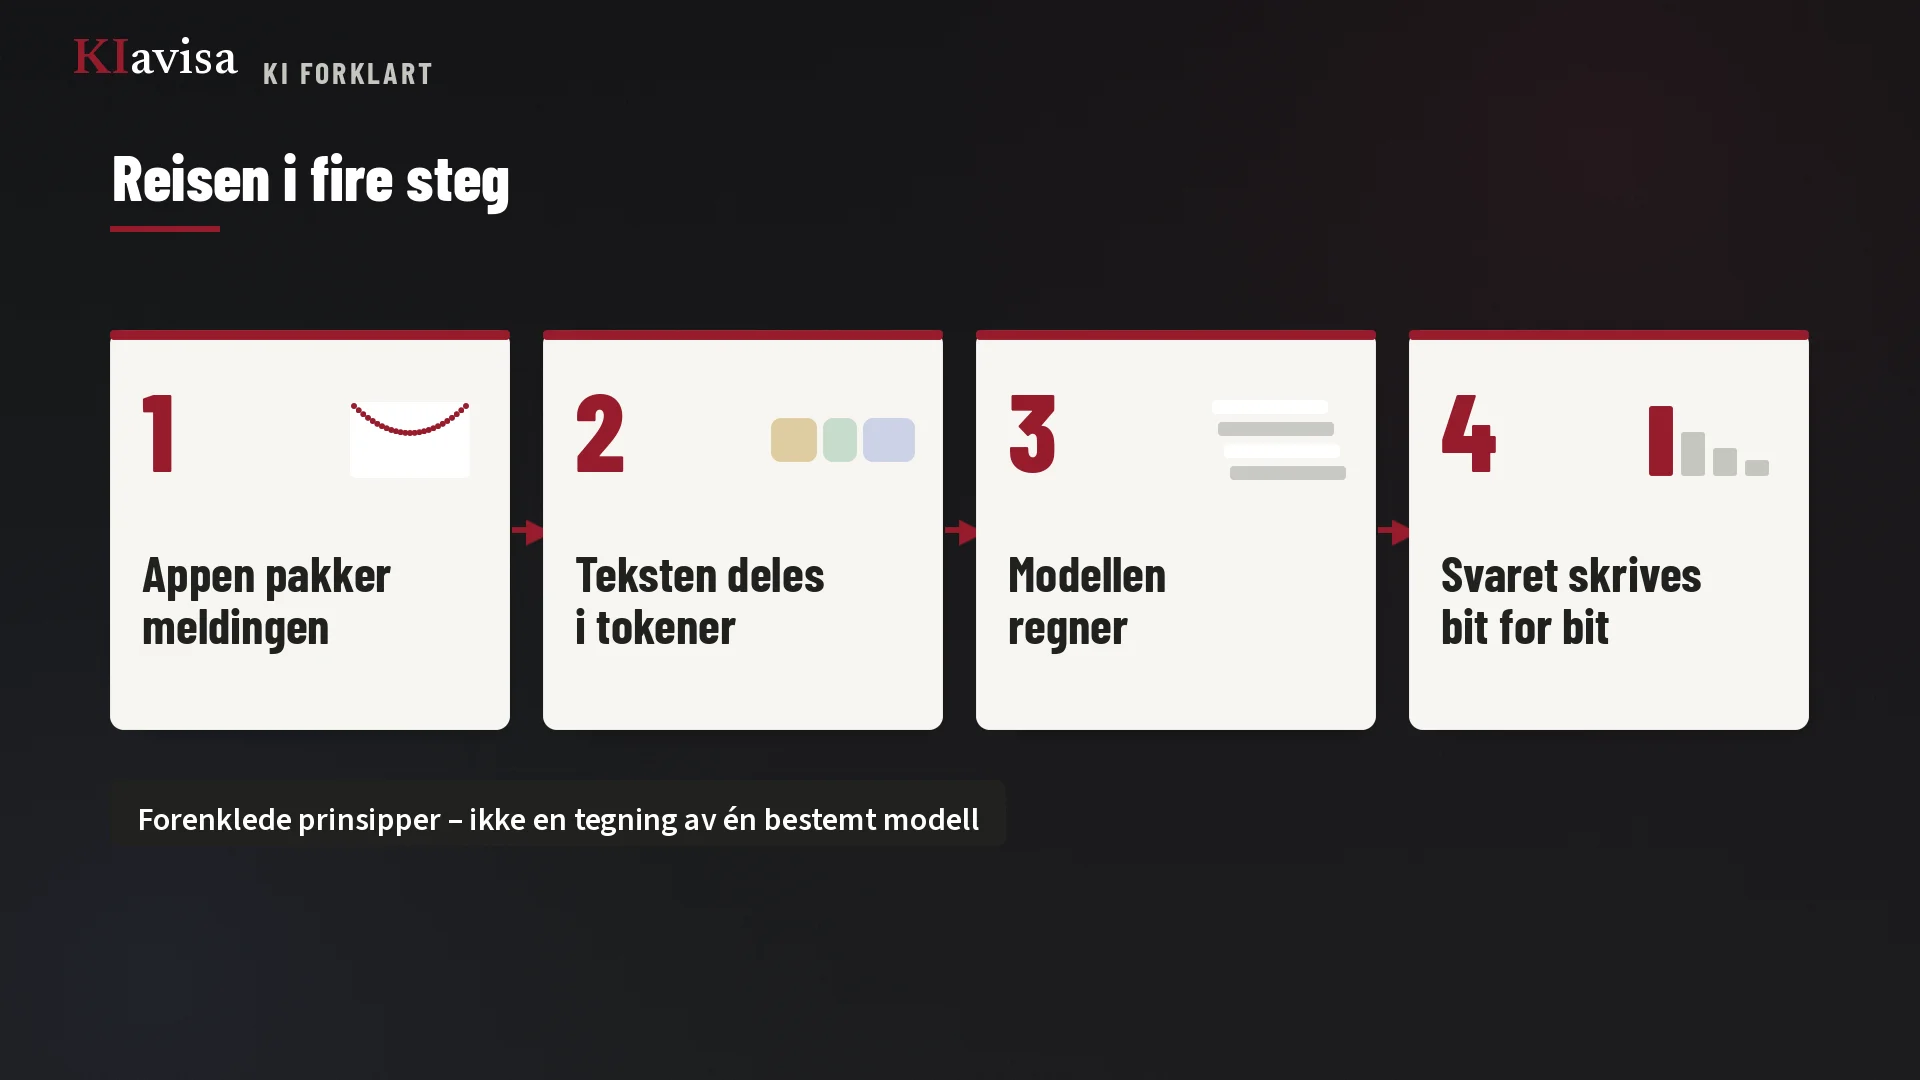
Du limer inn referatet fra foreldremøtet i et KI-program og skriver: «Oppsummer i tre punkter.» Så trykker du enter. Tre punkter dukker opp. Men hvor ble de egentlig laget? På maskinen foran deg, eller i et datasenter et helt annet sted? Vinduet ser helt likt ut. I denne videoen sender vi det samme referatet to veier. Én gang lokalt, på PC-en. Og én gang til en skytjeneste. Etterpå vet du hva lokal KI faktisk betyr, hva som reiser over nettet, og hvilke spørsmål du bør stille før du limer inn noe privat. Vi tar det i fire steg. Først de tre delene et KI-program består av. Så vei A: lokalt. Så vei B: skyen. Og til slutt nettet rundt, som kan være der selv når modellen er lokal. Vi bruker dokumentasjonen til Ollama som eksempel, et program som kan gjøre begge deler. Det er ingen produktanbefaling.
Et KI-program har tre deler som er lette å blande sammen. Appen er vinduet der du skriver og leser. Modellen gjør beregningene og lager teksten. Og verktøy er ekstra funksjoner, for eksempel et nettsøk, som henter noe for modellen. Tenk på en restaurant. Appen er servitøren som tar imot bestillingen. Modellen er kjøkkenet som lager maten. Og spørsmålet i denne videoen er rett og slett: Hvor ligger kjøkkenet? I samme hus, eller i et storkjøkken et annet sted? Men her slutter analogien å stemme. En restaurant har kjøkkenet sitt på ett sted. Et KI-program kan bytte kjøkken fra én forespørsel til den neste, uten at vinduet ser annerledes ut.
Vei A: lokalt. Før du kan kjøre en modell på egen maskin, må modellfilen ligge der. Ollamas dokumentasjon beskriver at modellene lastes ned fra internett. Det skjer på forhånd, ikke hver gang du spør. Når du trykker enter, lastes modellen inn i minnet, hvis den ikke ligger der fra før. Det kan være vanlig arbeidsminne, minnet på skjermkortet, eller litt i hvert. Ollama kan vise dette som for eksempel hundre prosent GPU eller hundre prosent CPU. Så skjer beregningen på din egen prosessor eller ditt eget skjermkort. I Ollamas eksempler går forespørselen til en adresse som heter localhost. Det betyr rett og slett: denne maskinen. Referatet trenger ikke reise noe sted for å bli oppsummert, og Ollama skriver at selskapet ikke ser spørsmålene dine når du kjører lokalt. Prisen er at maskinen din må gjøre jobben. Modellen må få plass i minnet. Er skjermkortet for lite, deles modellen mellom skjermkortet og det vanlige minnet. Hvor mye minne en modell trenger, har vi en egen video om.
Vei B: skyen. Nå velger du en skymodell i stedet. Da sendes referatet og spørsmålet ditt over internett, til leverandørens maskiner. Og skyen er ikke en sky. Det er bygninger fulle av datamaskiner, som disse datasentrene. Der kjøres modellen på leverandørens maskinvare, og svaret sendes tilbake til appen din. For deg ser det helt likt ut. Men teksten din har vært innom en annen datamaskin. Fordelen er at maskinen din slipper å gjøre jobben. Ollama skriver at skymodellene ikke må lastes ned. Beregningen bruker leverandørens maskinvare, så modellen trenger ikke få plass i minnet ditt. Hva skjer så med teksten? Det avhenger av leverandøren. Ollama skriver at selskapet behandler spørsmål og svar for å levere tjenesten, men at innholdet ikke lagres eller logges, og ikke brukes til trening. Det er selskapets egen beskrivelse. Andre tjenester har andre vilkår.
Steg fire, og her går mange i en felle. Lokal betyr ikke det samme som frakoblet. Selv med en lokal modell kan programmet bruke nettet til andre ting. Ollama laster for eksempel ned programoppdateringer automatisk på Windows og Mac. Og modellen ble jo hentet fra internett. Det er nettbruk, men det er ikke det samme som at referatet ditt sendes ut. Verktøyene er det store spørsmålet. En modell kan be om et verktøy, for eksempel et nettsøk. Ifølge Ollamas dokumentasjon er det programmet rundt modellen som kjører verktøyet, og resultatet sendes tilbake til modellen. Ollamas eget nettsøk går til ollama.com og krever en konto. Da sendes søkeordene ut, selv om modellen regner lokalt. Modellen kan altså være lokal, mens verktøyet bruker nettet. Ollama har også en lokalmodus som slår av selskapets skyfunksjoner. Da forsvinner skymodellene og nettsøket. Men innstillingen gjelder Ollama, ikke alle andre programmer på maskinen.
Kort oppsummert, med tre spørsmål du kan stille. Én: Hvor kjører modellen, på maskinen din eller hos en leverandør? To: Hva sender appen og verktøyene ut på nettet? Tre: Når teksten forlater maskinen, hva sier leverandøren om lagring og trening? Svaret på skjermen ser likt ut. Forskjellen ligger i reisen bak det. Kildene finner du på kiavisa.no. Fortellerstemmen er syntetisk, laget med Gemini-stemmen Charon.