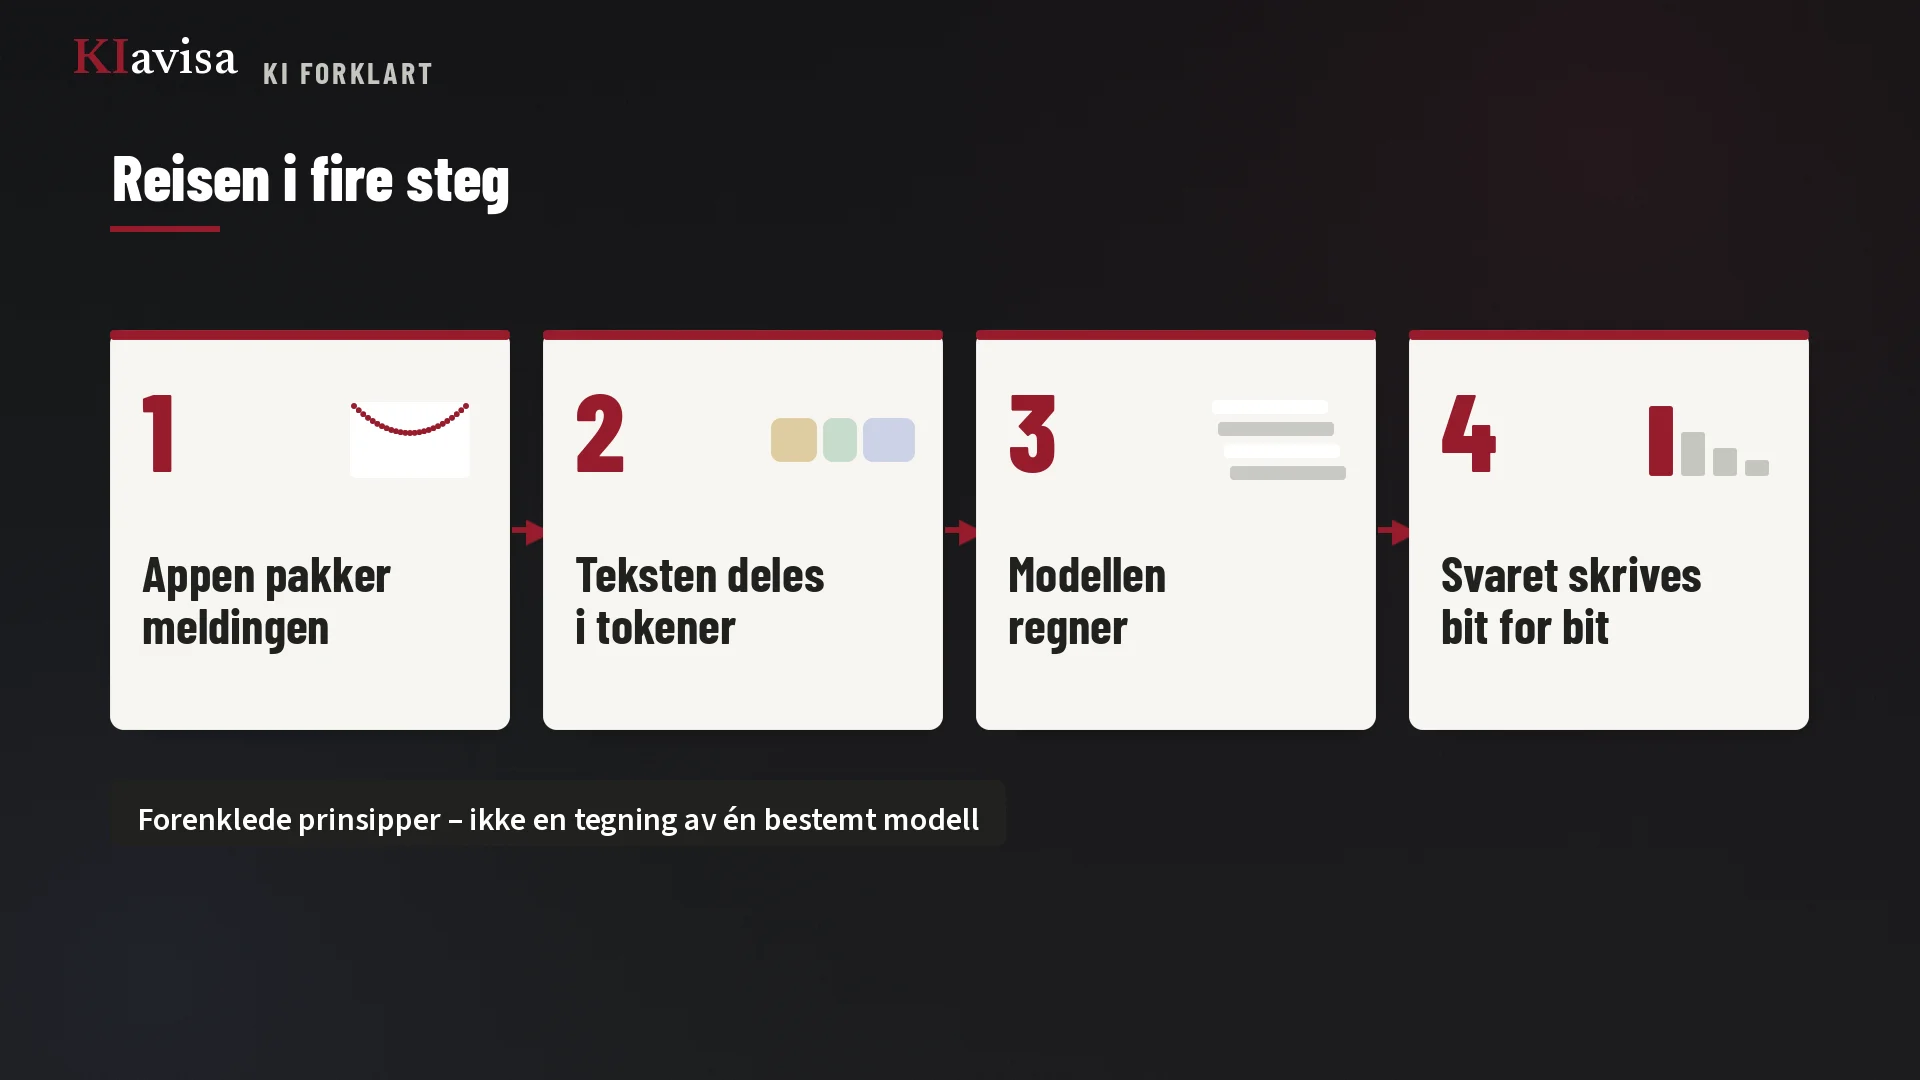
Du skriver et spørsmål til ChatGPT: «Hva bør jeg lage til middag? Jeg har egg, spinat og ris.» Du trykker enter. Etter et øyeblikk begynner svaret å dukke opp, bit for bit. Men hva skjer egentlig i de sekundene? I denne videoen følger vi akkurat det spørsmålet hele veien gjennom maskinen. Når vi er ferdige, vet du hvordan en språkmodell lager et svar, og hvorfor den noen ganger tar feil. Reisen har fire steg. Først pakker appen meldingen din. Så deles teksten opp i små biter. Deretter regner modellen. Og til slutt skrives svaret, én bit om gangen. Diagrammene viser forenklede prinsipper, ikke en tegning av én bestemt modell.
Først et viktig skille. ChatGPT er appen du skriver i. Inne i den bruker OpenAI språkmodeller, som gjør selve tekstarbeidet. Appen sender ikke bare spørsmålet ditt videre. Den pakker det sammen med instruksjoner, tidligere meldinger i samtalen og annet innhold som skal være med. Alt dette til sammen kalles konteksten. Tenk på det som en konvolutt der spørsmålet ditt bare er ett av arkene. Skrev du tidligere i samtalen at du ikke spiser kjøtt, kan det ligge i konvolutten også. Da kan svaret ta hensyn til det. Men konvolutten har en størrelsesgrense, et kontekstvindu. I en veldig lang samtale får ikke alt plass, og hvilken historikk som tas med, avhenger av appen og modellen.
Steg to. En språkmodell leser ikke bokstaver slik du gjør. Teksten deles først opp i tokener. Et token kan være et helt ord, en del av et ord eller et enkelt tegn. Middagsspørsmålet vårt kan for eksempel bli delt slik: Hva, bør, jeg, lage, til, middag, og spørsmålstegnet for seg. Lange eller sjeldne ord blir ofte delt i flere biter. Nøyaktig hvordan, avhenger av språket og av programmet som deler opp teksten, tokenizeren. Hvert token blir så gjort om til et nummer. Datamaskinen regner med tall, ikke med ord. Inne i modellen blir hvert token til en lang rekke tall, en såkalt embedding. Den plasserer ordet i et slags betydningslandskap, der ord som brukes på lignende måter, havner nær hverandre. Egg og omelett vil typisk ligge nærmere hverandre enn egg og motorsykkel.
Steg tre: selve regnestykket. Modellen består av et enormt antall tall som kalles parametere. De ble justert under trening på store mengder tekst, lenge før du stilte spørsmålet ditt. Du kan tenke på det som en som har lest et helt bibliotek og lært seg mønstrene i språket. Men her slutter analogien å stemme: Modellen har ikke bøkene liggende og slår ikke opp i dem når den svarer. Det den lærte, ligger i parameterne. Trening og bruk er altså to ulike ting. Når du får et svar, brukes en modell som allerede er ferdig trent. De fleste store språkmodeller bygger på en arkitektur som kalles transformer. Tallene for hvert token sendes gjennom mange lag med beregninger, der resultatet fra ett lag går videre til det neste. I lagene finnes en viktig mekanisme: attention, eller oppmerksomhet. Den vekter hvilke andre tokener som betyr mest for hvert token. Forenklet sagt: For å forstå hva slags middag du trenger, får egg, spinat og ris mye vekt, mens et lite ord som «til» betyr mindre. Alt dette skjer på kraftige maskiner i datasentre, ikke på telefonen din. Og det er mange beregninger for hvert eneste token.
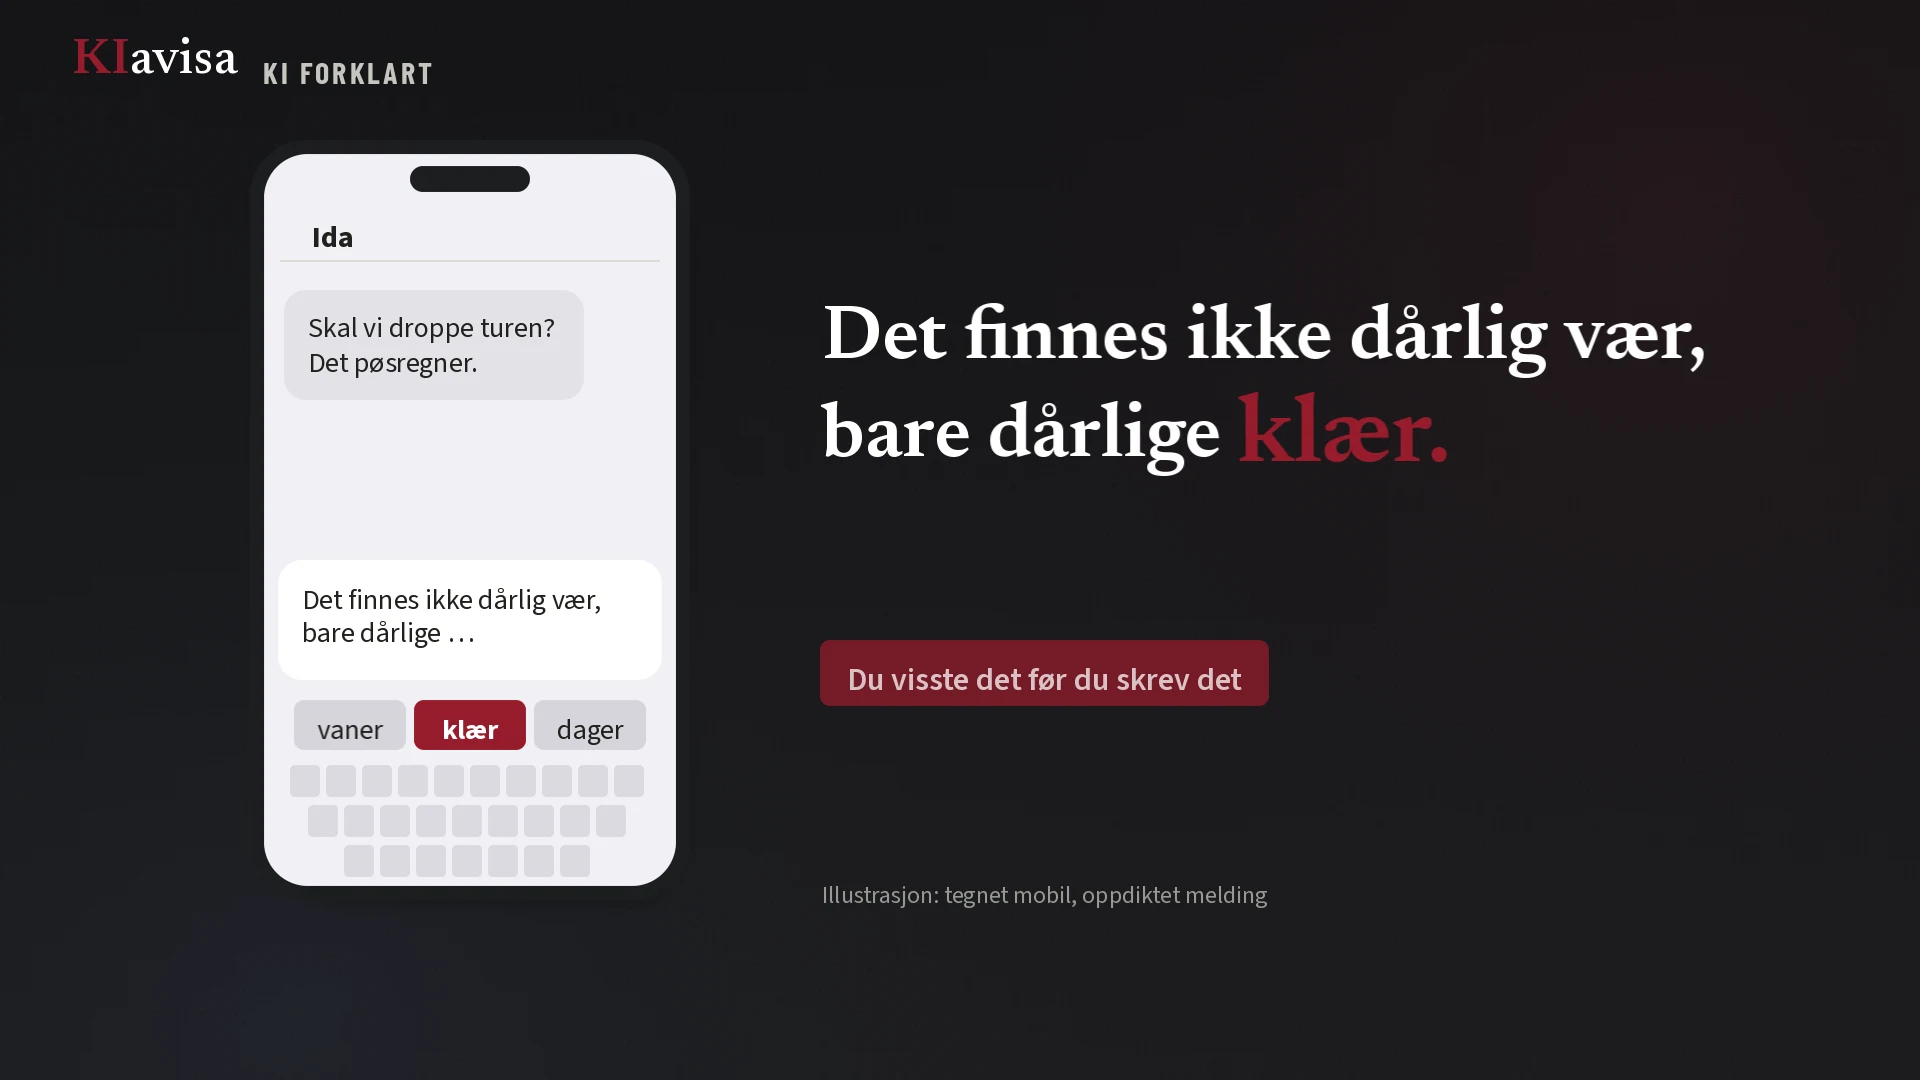
Steg fire, og her kommer kanskje det mest overraskende. Resultatet av alle beregningene er ikke et ferdig svar. Det er en liste med sannsynligheter for hva neste token kan være. Etter spørsmålet vårt kan «Du» være ganske sannsynlig som første ord, men også «En» eller «Hva». Ett av dem velges. Så legges det valgte tokenet til teksten, og hele runden kjøres på nytt for neste token. Og neste. Et svar på noen hundre ord krever altså hundrevis av runder. Derfor ser du svaret vokse fram bit for bit. Appen kan vise tokenene etter hvert som de blir laget. Modellen har ikke hele svaret ferdig fra starten. Modellen velger heller ikke alltid det mest sannsynlige tokenet. Litt variasjon i valget, styrt av innstillinger, gjør at samme spørsmål kan gi ulike svar. Spør du to ganger, kan du få spinatomelett den ene gangen og stekt ris med egg den andre.
To ting kan komme i tillegg. Noen modeller bruker egne resonneringstokener før de skriver svaret. OpenAI beskriver at det hjelper modellen å bryte ned oppgaven og vurdere ulike tilnærminger. Du ser vanligvis ikke disse tokenene, og de er ingen garanti for et riktig svar. Modellen kan også be om et verktøy, for eksempel et nettsøk. Da er det programvaren rundt modellen som utfører søket. Resultatet legges tilbake i konteksten, altså i konvolutten, og modellen skriver videre. Og så feilene. Fordi modellen bygger svaret av sannsynlige fortsettelser, kan den lage tekst som høres helt riktig ut, men som er feil. Det kalles ofte hallusinasjoner. En oppdiktet kilde kan se ryddig ut. Et sannsynlig ord er ikke det samme som en kontrollert opplysning. Så når fakta betyr noe: Sjekk kilden.
Kort oppsummert. Én: Appen pakker meldingen din sammen med samtalen til en kontekst. To: Teksten blir til tokener og tall, som modellen regner på gjennom mange lag. Tre: Svaret skrives ett token om gangen, ut fra sannsynligheter. Derfor kan det variere, og derfor bør viktige fakta sjekkes. Neste gang du trykker enter, vet du hva som skjer i de sekundene. Kildene finner du på kiavisa.no. Fortellerstemmen er syntetisk, laget med Gemini-stemmen Charon.