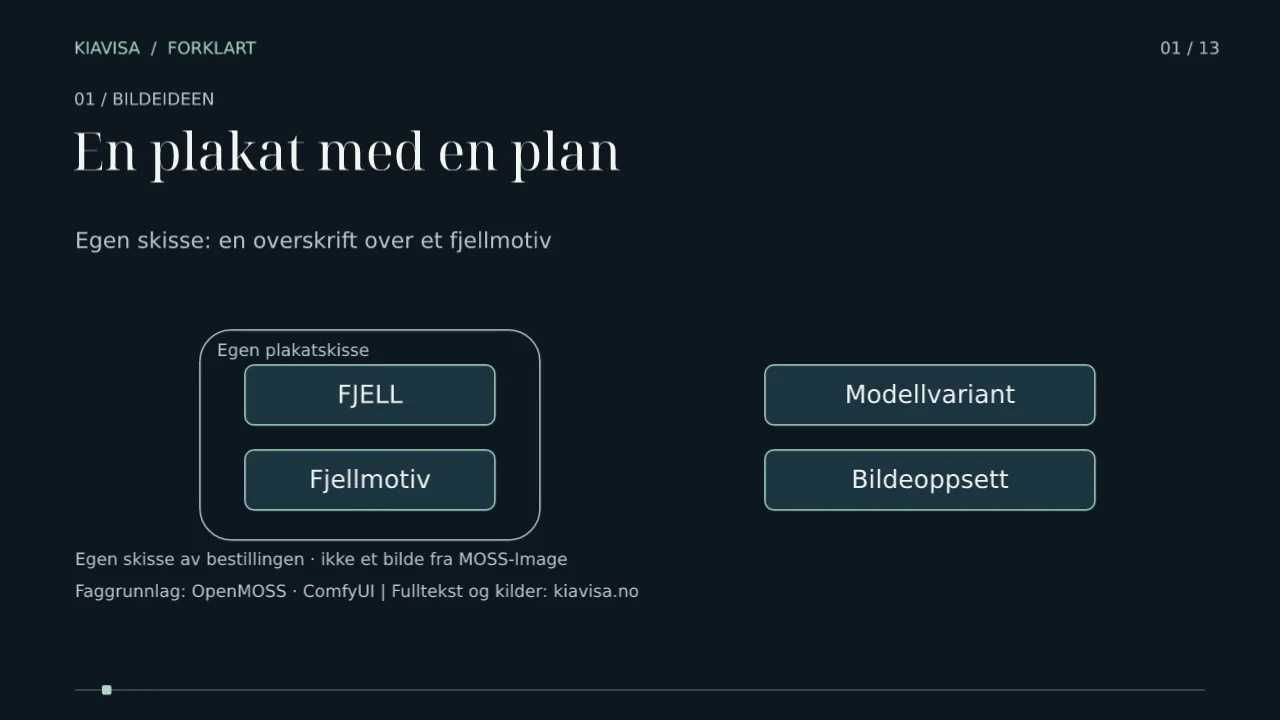
Tenk deg en plakat med ordet «FJELL» øverst og et fjellmotiv nedenfor. Det er vårt eget forklaringseksempel, ikke et bilde fra MOSS-Image. Vi bruker det til å vise to forskjellige valg: hvilken modellvariant som brukes, og hvordan innholdet i bildet beskrives. Dette er bakgrunnsstoff, ikke en lanseringsnyhet.
OpenMOSS beskriver MOSS-Image-Base som en modell som lager bilder fra tekst. MOSS-Image-SFT er ifølge samme kilde viderejustert fra Base på utvalgte data. Pilene mellom dem viser altså et forhold mellom to modellvarianter. De viser ikke at begge må kjøres etter hverandre hver gang et bilde lages.
Her skiller vi mellom viderejusteringen som beskriver SFT-utgaven, og oppsettet som sendes inn når et bilde skal lages. Det første handler om modellvarianten. Det andre handler om den enkelte bildebestillingen. Et JSON-oppsett er derfor ikke i seg selv en viderejustering av modellen, men en måte å beskrive ønsket innhold på.
I prosjektets README framhever OpenMOSS ett eksempel der SFT skal gi tydeligere tekstgruppering og et mer organisert tavleoppsett. Det er utgiverens beskrivelse av sitt eget eksempel. Vi gjør den ikke om til en påstand om at SFT alltid er bedre, eller til et resultat fra en test utført av KIavisa.
Tilbake til plakaten. MOSS-Image dokumenterer et strukturert oppsett med en overordnet beskrivelse og en liste over enkeltelementer. Feltet summary.caption beskriver hele scenen og stilen. I vårt eksempel kan helheten være en enkel plakat med lys bakgrunn, en overskrift og et fjellmotiv. Det er en illustrert bestilling, ikke et generert resultat.
Listen items beskriver elementene hver for seg. Dokumentasjonen bruker blant annet feltene label, caption og bbox. For tekst kommer også feltet text, med ordene som skal stå i bildet. Dermed kan overskriften «FJELL» beskrives som ett element og fjellmotivet som et annet, i stedet for at alt bare ligger i én sammenhengende setning.
Bbox er avgrensningsboksen som angir hvor et element skal plasseres. I skissen får overskriften et område nær toppen, mens motivet får et område nedenfor. Boksene er altså en del av beskrivelsen av ønsket oppsett. De er ikke dokumentasjon på hvor presist modellen faktisk vil plassere elementene i et ferdig bilde.
I det dokumenterte formatet abs_centralized regnes pikselkoordinatene fra midten av lerretet. For et lerret på 1024 ganger 1024 går aksene fra minus 512 til pluss 512. X øker mot høyre, og Y øker nedover. Et negativt Y-tall plasserer derfor en grense ovenfor midten, ikke nedenfor.
Dokumentasjonen bruker også formatnavnet yxyx. Tallene kommer da i rekkefølgen minste Y, minste X, største Y og største X. Det betyr øvre grense, venstre grense, nedre grense og høyre grense i dette koordinatsystemet. Formatnavnet forklarer hvordan tallrekken skal tolkes; det er ikke fire uavhengige plasseringer.
README beskriver at JSON-oppsettet kan limes inn i promptfeltet i Gradio. Bredde og høyde skal samsvare med koordinatene. Plakatens felter blir dermed strukturerte inndata til bildegenereringen. En skisse av disse feltene viser hva som bestilles, men erstatter fortsatt ikke et faktisk bilde som modellen har produsert.
MOSS-Image er heller ikke bare omtalt som en framtidig ComfyUI-integrasjon. Versjonsnotatene for ComfyUI 0.42.0 oppgir MOSS-støtte, og den gjennomgåtte README-en beskriver nå innebygd støtte. Det dokumenterer hva utgiverne oppgir om integrasjonen. Vi har ikke installert den eller kontrollert hvordan et konkret oppsett fungerer på en bestemt maskin.
Plakateksempelet gir oss tre ting å holde fra hverandre: modellen som brukes, oppsettet som beskriver bildet, og resultatet som eventuelt blir generert. Base og SFT handler om det første. JSON-feltene handler om det andre. Denne forklaringen viser dokumentasjonen med egne diagrammer, ikke kvaliteten på faktiske MOSS-bilder. Originalkildene følger manuskriptet.