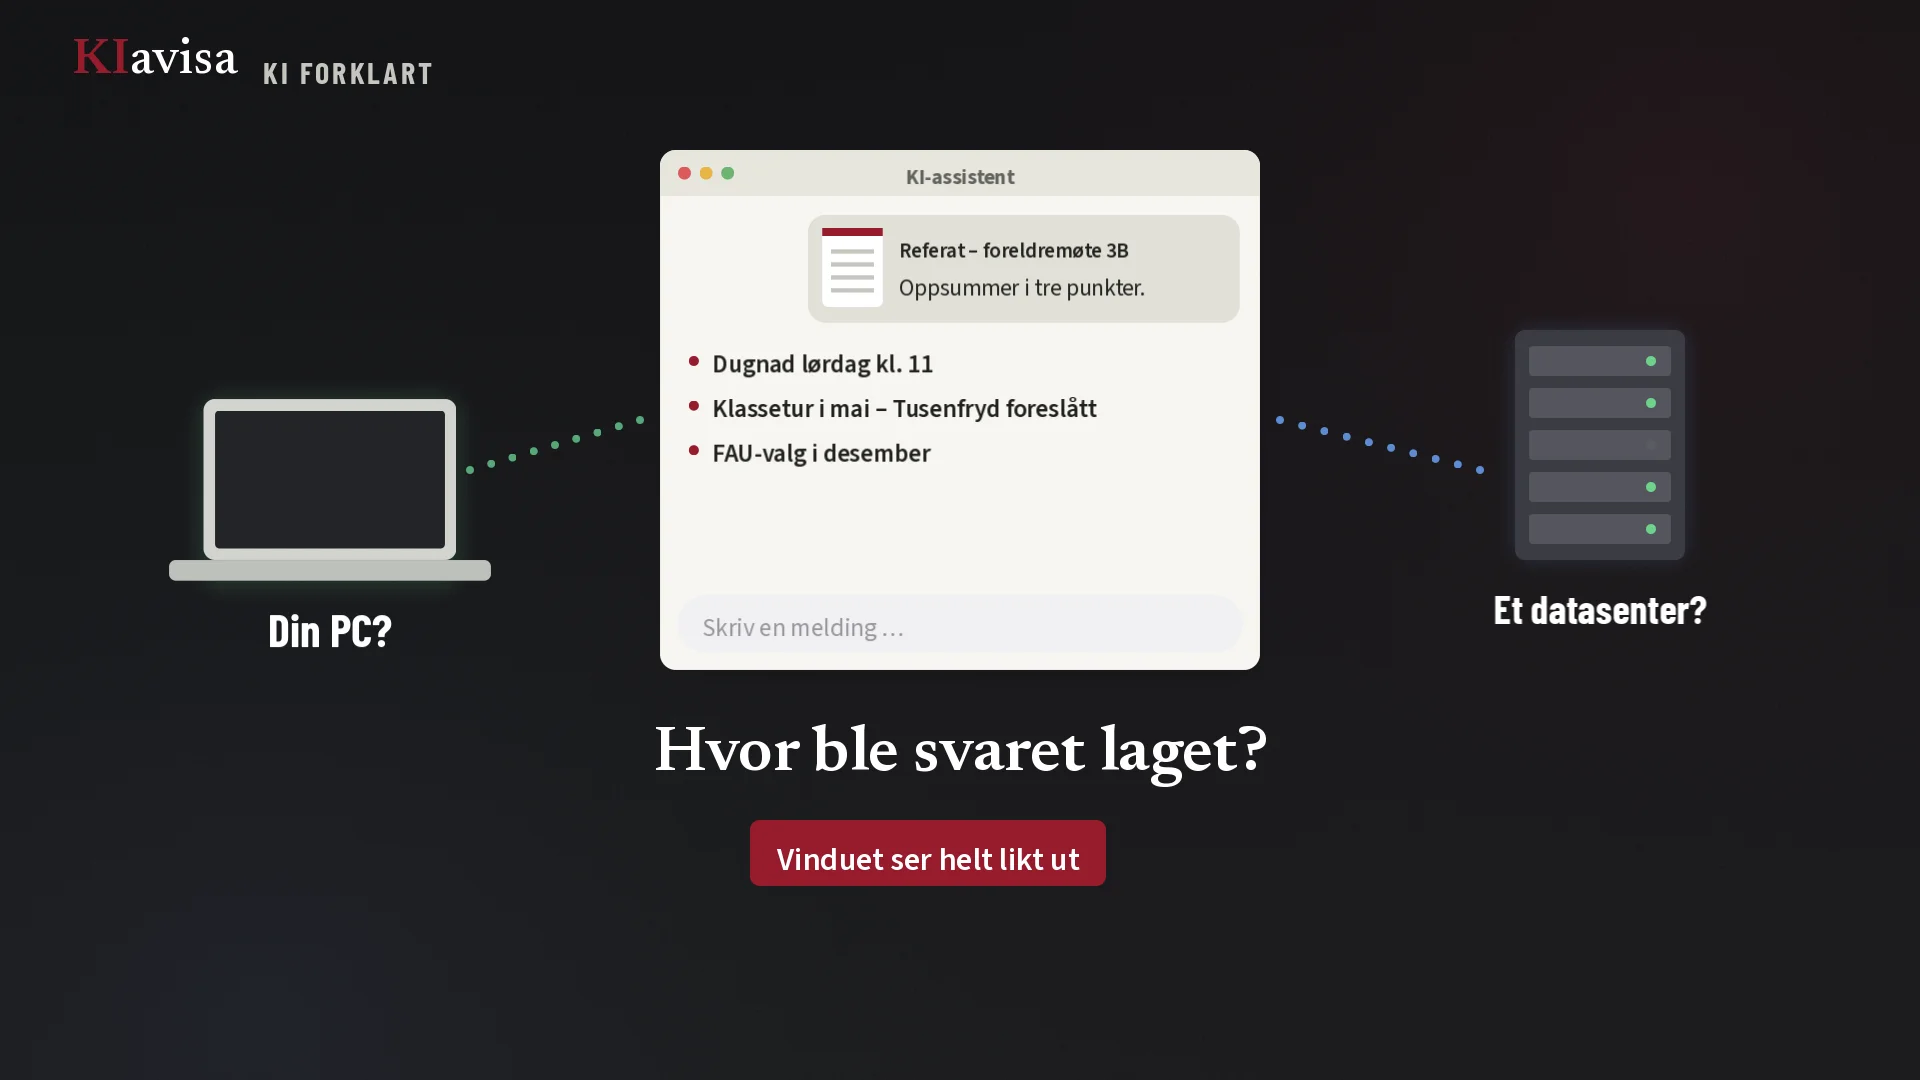
Du vil ha en KI-assistent på din egen bærbare PC. Den skal svare på spørsmål om bruksanvisningen til varmepumpa, som er på åtti sider. Du laster ned en språkmodell, og modellfila får fint plass på disken. Så limer du inn hele bruksanvisningen og spør: «Hvorfor blinker den røde lampen?» Har maskinen plass til dette også? Det er faktisk et annet spørsmål. Etter denne videoen vet du hva som tar plass når en modell lagres, og hva som tar plass når den kjører. Eksempelet er oppdiktet, regnestykket er forenklet, og dette er verken en maskinvaretest eller et kjøpsråd. Vi tar det i fire steg. Først: lagring og kjøring. Så: hvor i maskinen modellen kjører. Deretter: hvordan kvantisering gjør tallene mindre. Og til slutt: hvorfor lang tekst og flere brukere krever mer minne.
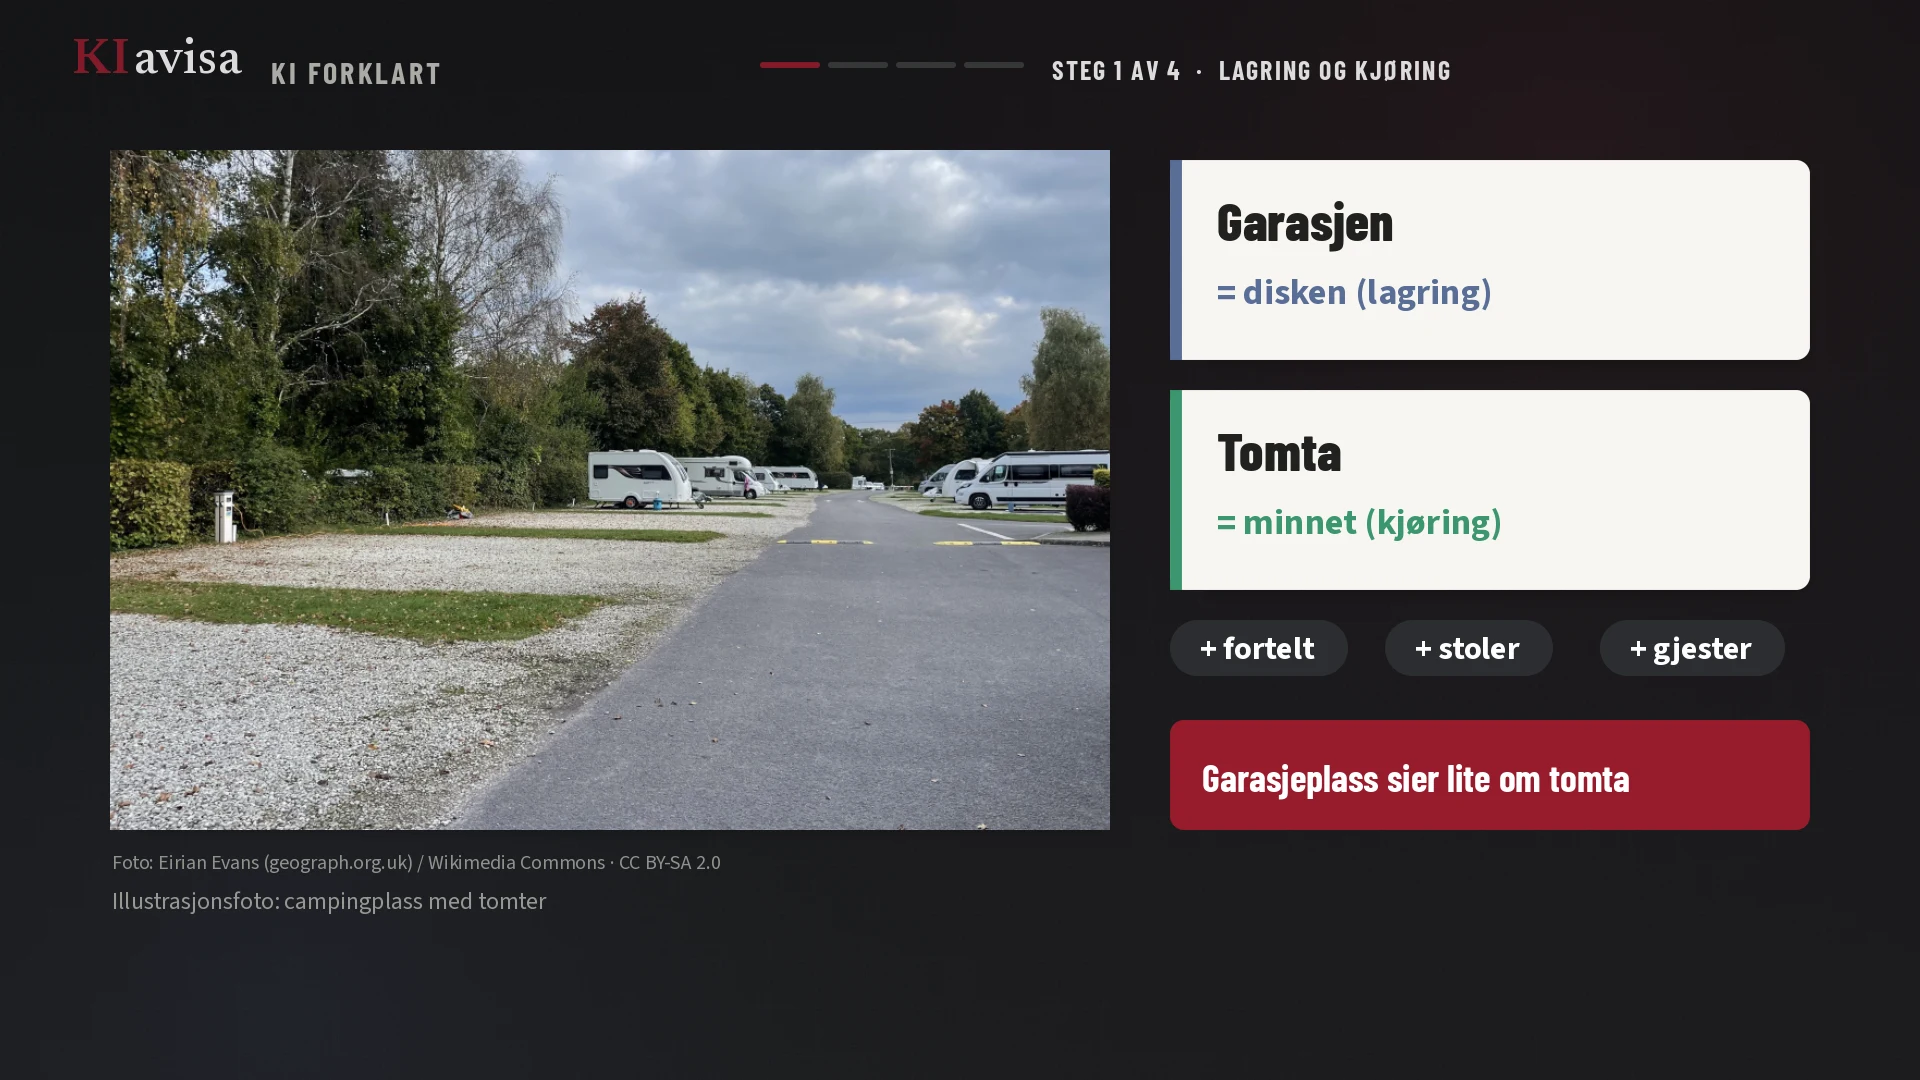
Disken er der modellfilene lagres. Ollama, et program for å kjøre språkmodeller lokalt, oppgir hvilken mappe filene havner i, og at du kan flytte dem et annet sted. Men når du stiller et spørsmål, må modellen lastes inn i minnet. Det er der beregningene skjer. Ollama lar som standard modellen ligge i minnet i fem minutter etter bruk, så neste svar kommer raskere. Tenk på en bobil. Hjemme trenger den en plass i garasjen. På campingplassen trenger den en tomt, og der skal det også være plass til fortelt, stoler og gjester. At bobilen får plass i garasjen, sier lite om hvor stor tomt du trenger. Her halter bildet litt. Modellfila blir liggende på disken også mens modellen kjører. Og hvor mye plass som trengs rundt modellen, avhenger av innstillingene dine. Det kommer vi tilbake til.
Datamaskinen har vanlig arbeidsminne, RAM. Har den et eget grafikkort, har det sitt eget minne, kalt VRAM. Modellen kan ligge i det ene, i det andre, eller fordelt på begge. Ollama viser det svart på hvitt. GPU betyr grafikkprosessoren, CPU betyr hovedprosessoren. Hundre prosent GPU, hundre prosent CPU, eller for eksempel førtiåtte og femtito prosent fordelt. Ifølge Ollama går det best når modellen ikke må deles over til CPU-en. Men ikke alle maskiner har to adskilte minner. På Mac-er med Apple silicon deler hovedprosessoren og grafikkprosessoren det samme minnet, skriver Apple i dokumentasjonen til MLX. Da er det ikke to bøtter du kan legge sammen. Og noe av minnet er opptatt før modellen er på plass. Hugging Face skriver at programkoden som lastes inn på grafikkortet, kan ta én til to gigabyte. Du har alltid litt mindre å gå på enn det som står på esken.
Hva er det egentlig som tar plass i modellfila? I hovedsak tall, milliarder av dem, kalt vekter. Hvor mye plass de tar, avhenger av hvor mange bit hvert tall lagres med. Kvantisering betyr å lagre tallene med lavere presisjon. Hugging Face beskriver for eksempel overgangen fra trettito bit til åtte bit per tall. Da trengs mindre minne og lagring. Litt som å si «omtrent hundre og tretti kroner» i stedet for hundre og tjueni og nitti. Kortere, men også grovere. Derfor kan kvantisering påvirke svarene. «Fire bit» på en modell er verken en kvalitetsgaranti eller et løfte om fart på din maskin. Ta et rent regnestykke. Åtte milliarder vekter, hver lagret med nøyaktig fire bit. Åtte bit er én byte. Da blir det fire milliarder byte, altså fire gigabyte. Men det gjelder bare vektene, i en idealisert verden. Kvantisering trenger også ekstra tall som forteller hvordan verdiene skal tolkes. Hugging Face kaller dem skala og nullpunkt. Og under kjøringen kommer mer i tillegg. Fire gigabyte er derfor ingen målt filstørrelse og ikke et minstekrav.
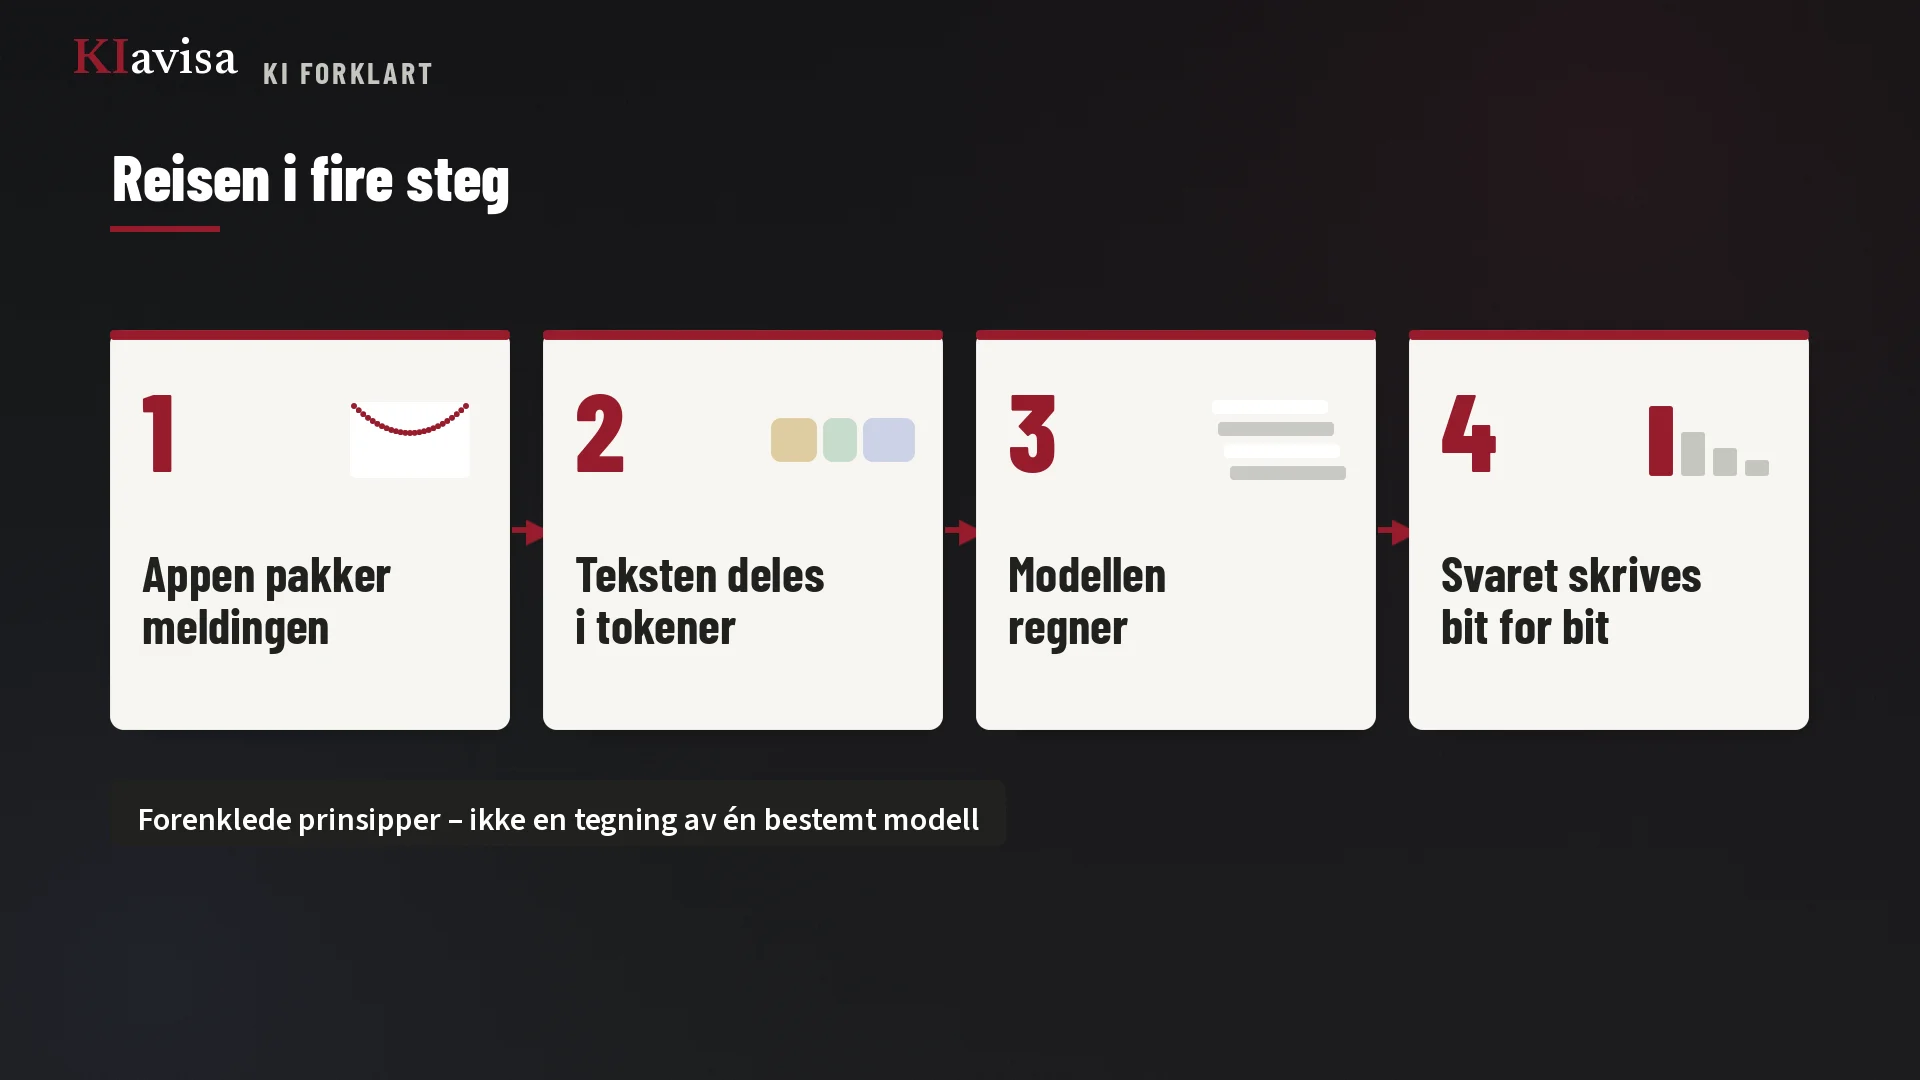
Nå limer du inn bruksanvisningen. Teksten deles opp i tokener, hele ord eller biter av ord. Kontekstlengden er hvor mange tokener modellen har tilgang til i minnet, skriver Ollama. Og Ollama er tydelig: Større kontekstlengde krever mer minne. Har maskinen under tjuefire gigabyte grafikkminne, er standarden rundt fire tusen tokener. Åtti sider bruksanvisning blir fort langt mer enn det. Hvorfor koster lang tekst minne? En del av svaret er KV-cachen. Den tar vare på beregninger for tekstbitene som allerede er lest, så de slipper å regnes ut på nytt. Hugging Face forklarer at den vokser jevnt med teksten, med mindre den har en fast størrelse. Også dette mellomlageret kan gjøres mindre. Ollama kan lagre det med åtte bit i stedet for seksten. Det bruker omtrent halvparten så mye minne, med et lite tap i presisjon. Og hvis to i huset spør samtidig? Ifølge Ollama ganges konteksten med antall samtidige forespørsler. To tusen tokener og fire forespørsler blir åtte tusen, og mer minne. Samme modellfil, altså, men ulikt minnebehov.
Kort oppsummert. Én: Plass til modellfila på disken er ikke det samme som plass til å kjøre den. To: Kvantisering gjør vektene mindre, men kan påvirke svarene, og vektene er bare en del av regningen. Tre: Lang tekst og flere samtidige brukere krever mer minne, selv med samme modell. Lurer du på hvorfor man vil kjøre KI lokalt i det hele tatt, se videoen «Lokal KI og sky». Og hva som ligger i konteksten, forklarer vi i «Hva betyr kontekst?». Kildene finner du på kiavisa.no. Fortellerstemmen er syntetisk, laget med Gemini TTS.