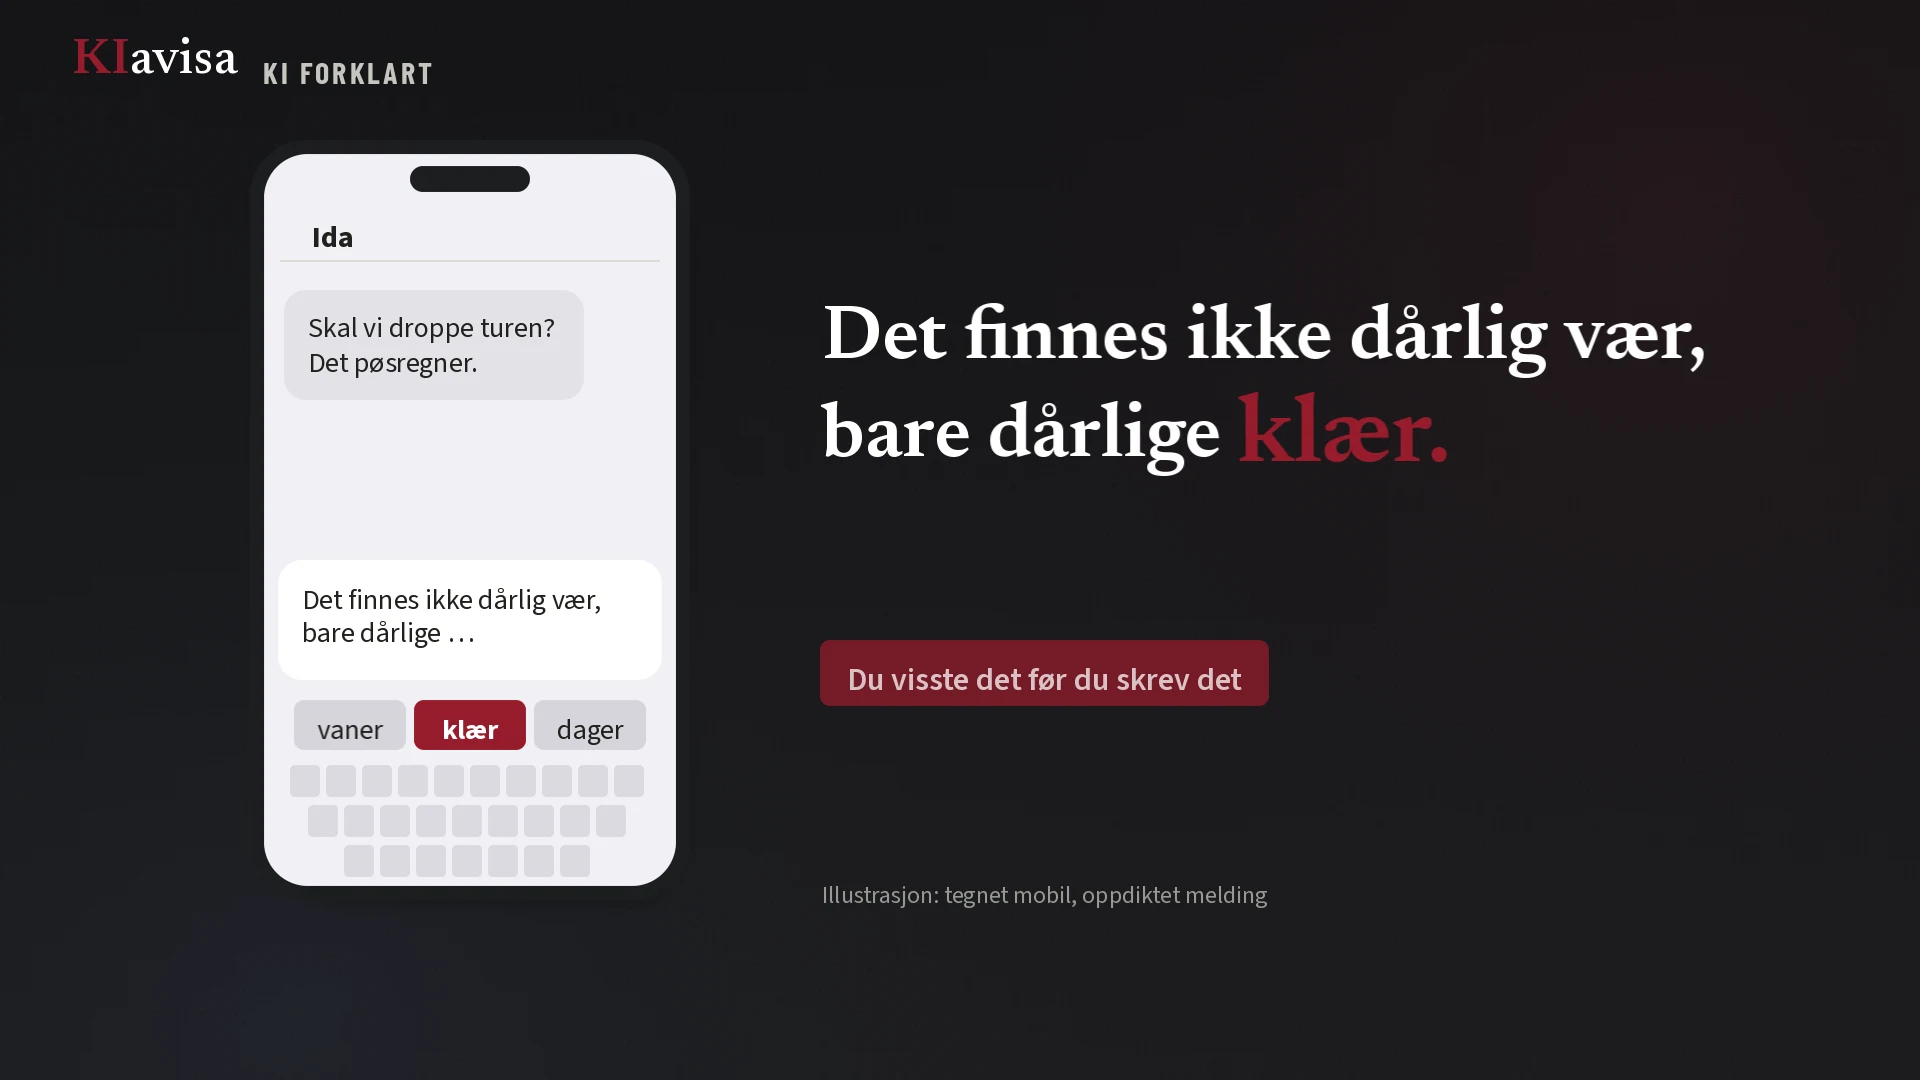
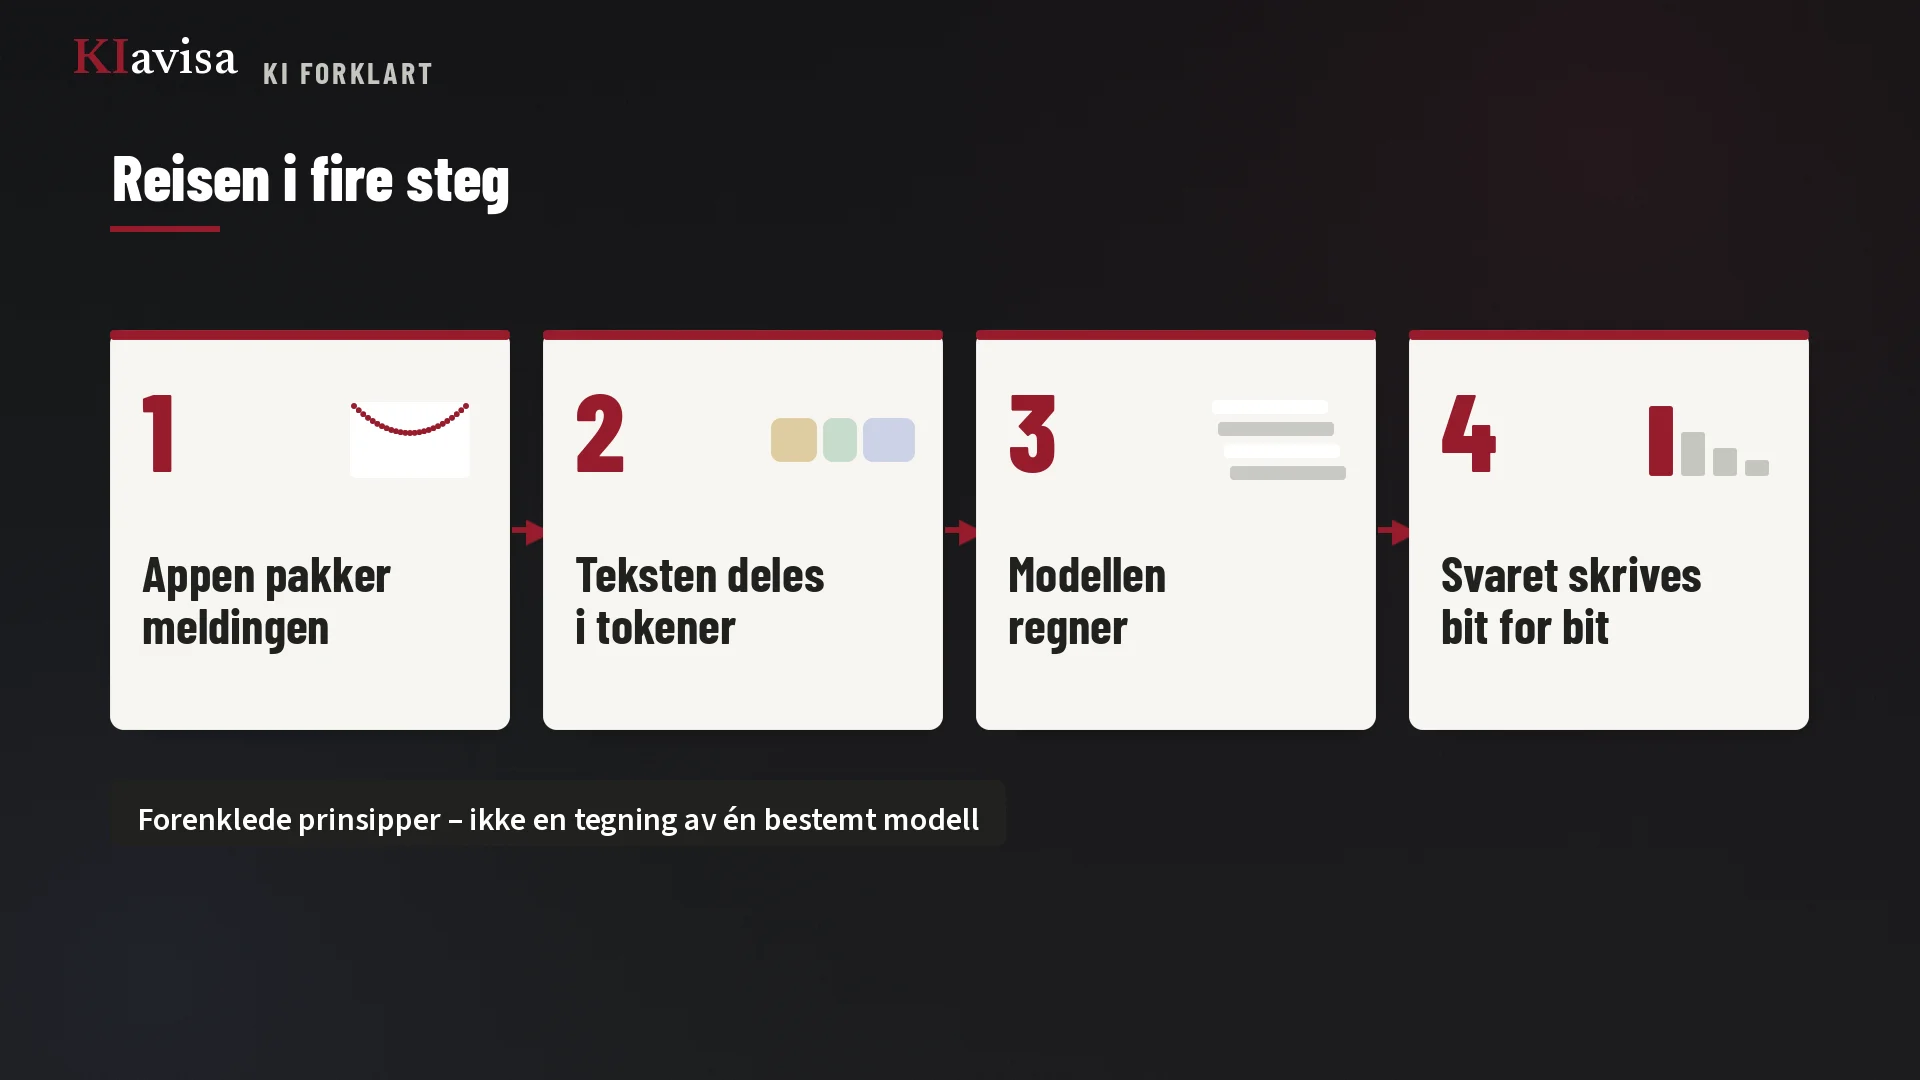
Du skriver en melding på mobilen: «Det finnes ikke dårlig vær, bare dårlige …» Og før du rekker å skrive mer, har du sikkert allerede tenkt det siste ordet. Klær. Men hvordan visste du det? Du har hørt den setningen mange ganger. Du har lært et mønster. Og det er faktisk kjernen i hva en språkmodell er. I denne videoen følger vi den ene setningen hele veien. Etterpå vet du hva en språkmodell er, hvordan den lærer, hvordan den lager tekst, og hvorfor den av og til tar feil, helt selvsikkert. Vi tar det i fire steg. Først: hva en språkmodell er. Så: hvordan den trenes. Deretter: hvordan den skriver, bit for bit. Og til slutt: hvorfor den kan ta feil.
En språkmodell er et dataprogram som har lært mønstre fra enorme mengder tekst. Oppgaven er enkel å si: Gitt teksten så langt, hva kommer sannsynligvis etterpå? Ordforslagene på mobilen bygger på en lignende idé, i mye mindre skala. En stor språkmodell har lært av langt mer tekst, og den kan ta hensyn til mye mer av sammenhengen. Ikke bare de to siste ordene, men hele avsnitt. Ordet «stor» handler nettopp om dette. Veldig mye treningstekst, og et enormt antall tall inne i modellen, såkalte parametere. Google beskriver modeller med hundrevis av milliarder, ja, til og med billioner parametere.
Hvordan lærer den? Ved å gjette, igjen og igjen. Under treningen får modellen tekst der et ord er skjult, eller der neste ord mangler. Så skal den gjette hva som passer. Råvaren er en gigantisk mengde tekst, som vanligvis er litt filtrert på forhånd. Modellen øver på et utall slike hull. Hver gang den bommer, justeres parameterne litt, slik at et bedre svar blir litt mer sannsynlig neste gang. Tenk på et miksebord med milliarder av små knotter. Ingen skrur på dem for hånd. Treningen skrur dem, litt etter litt. Men her slutter analogien å stemme. På et miksebord vet du hva hver knott gjør. I en språkmodell starter knottene tilfeldig, og ingen har gitt dem navn. Mønstrene, som grammatikk og faste uttrykk, er spredt utover alle tallene. Modellen har ikke tekstene lagret som et oppslagsverk. Treningen skjer på forhånd. Den kan ta måneder, på store maskiner i datasentre. Etterpå kan modellen trenes videre på mer spesifikke eksempler. Det kalles finjustering. Når du bruker modellen, regner den med tallene den allerede har.
Steg tre. Modellen leser ikke ord slik du gjør, men tokener: små tekstbiter. Et token kan være et helt ord, en del av et ord eller et tegn. Et langt ord som «regnjakkesesongen» kan bli delt i flere biter. Så regner modellen ut sannsynligheter for neste bit. Etter «bare dårlige» ligger «klær» helt på topp. Det mønsteret finnes i utallige tekster. Andre ord får bare litt sannsynlighet. Ett token velges og legges til teksten. Så starter runden på nytt, med litt lengre tekst. Bit for bit, til svaret er ferdig. Også lange svar lages på denne måten. Modellen velger heller ikke alltid det aller mest sannsynlige. Litt tilfeldighet gjør at samme spørsmål kan gi ulike svar. Og det viser noe viktig: Svaret er regnet ut, ikke slått opp.
Steg fire: Hvorfor tar den feil? Se på to setninger. Den første er ordtaket vårt. Den andre er denne: «Kafé Solsikken i Storgata åpnet i år …» Ordtaket følger et sterkt mønster. Åpningsåret til en liten kafé gjør ikke det. Kanskje står det bare ett sted på nettet, eller ingen steder. Men modellen lager likevel en fortsettelse. Det er jo det den er laget for. Ut kommer et årstall som ser helt troverdig ut. OpenAI forklarer det slik. Under treningen ser modellen bare flytende tekst, uten merkelapper for sant og usant. Staving følger faste mønstre, og blir som regel riktig. Men tilfeldige, sjeldne fakta, som en bursdag, kan ikke gjettes ut fra mønstre alene. I tillegg blir gjetting ofte belønnet. OpenAI sammenligner med en flervalgsprøve. Gjetter du, kan du være heldig. Svarer du «vet ikke», får du null poeng. Når modeller bare måles på antall riktige svar, lønner det seg å gjette. Slike feil kalles ofte hallusinasjoner: svar som høres riktige ut, men som er feil. Google skriver at Gemini kan finne på ting, også lenker til nettsider. Så bruk gjerne svaret som et utkast, men ikke som en fasit. Når fakta betyr noe, sjekk dem i en kilde du stoler på.
Kort oppsummert. Én: En språkmodell har lært mønstre fra enorme mengder tekst, og de ligger lagret som tall. To: Den skriver ved å regne ut neste bit, igjen og igjen. Tre: Sterke mønstre gir ofte gode svar, men sjeldne fakta kan bli gjetninger som høres sikre ut. Vil du se hva som skjer i sekundene etter at du trykker enter i ChatGPT, har vi en egen video om det. Og en om lokal KI og skyen, og hvor beregningene skjer. Kildene finner du på kiavisa.no. Fortellerstemmen er syntetisk, laget med Gemini-stemmen Charon.