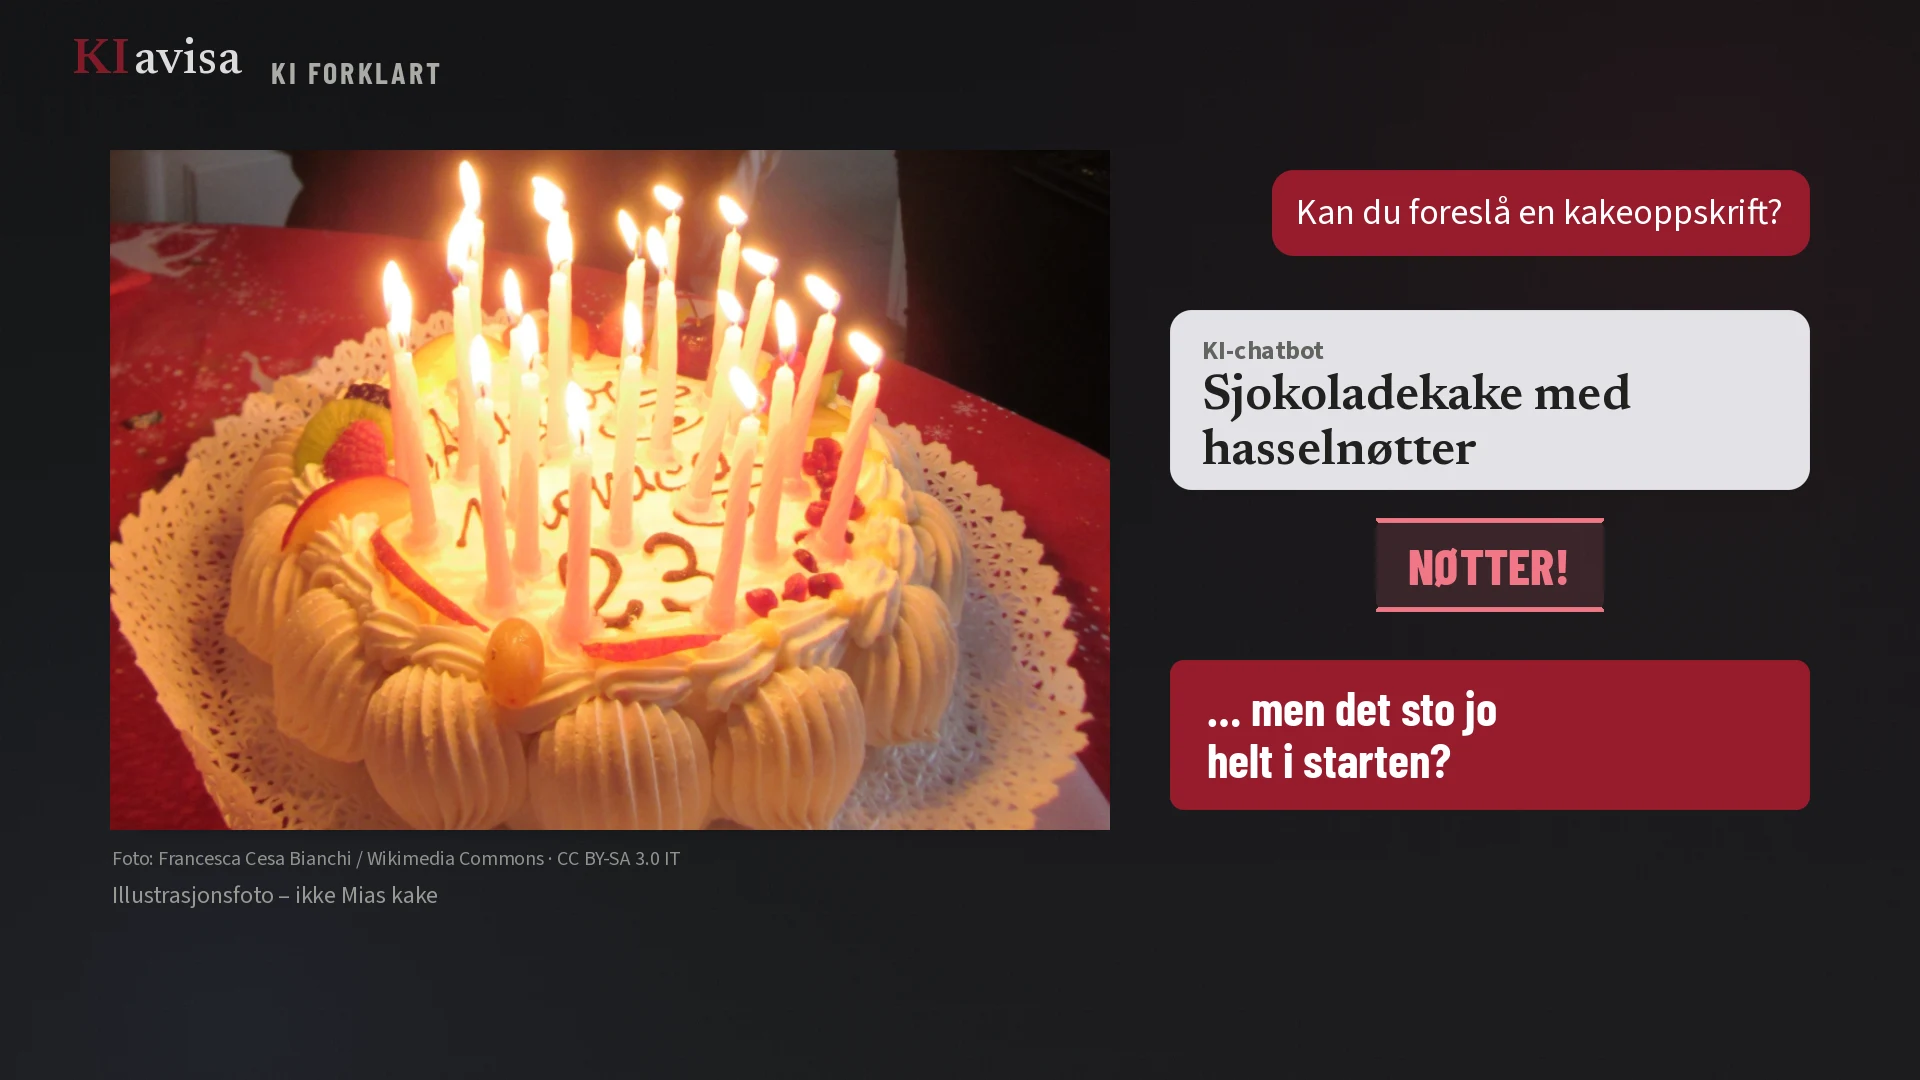
Du planlegger bursdagen til datteren din, Mia, sammen med en KI-chatbot. Helt i starten skriver du: «Mia tåler ikke nøtter.» Så går praten. Gjester, leker, pynt og handleliste. Mange meldinger senere ber du om en kakeoppskrift. Og forslaget er en sjokoladekake med hasselnøtter. Hvordan kan det skje, når du sa det helt i starten? Svaret handler om ett ord: kontekst. Etter denne videoen vet du hva kontekst er, hvorfor den kan bli full, og hvorfor den ikke er det samme som minne. Eksempelet er oppdiktet, og vi har ikke testet noen chatbot. Vi bruker Anthropics dokumentasjon for Claude som konkret eksempel. Andre chatapper kan gjøre det på andre måter. Vi tar det i fire steg. Først: hva kontekst er. Så: tokener, enheten den måles i. Deretter: hva som skjer når samtalen blir lang. Og til slutt: forskjellen på kontekst og lagret minne.
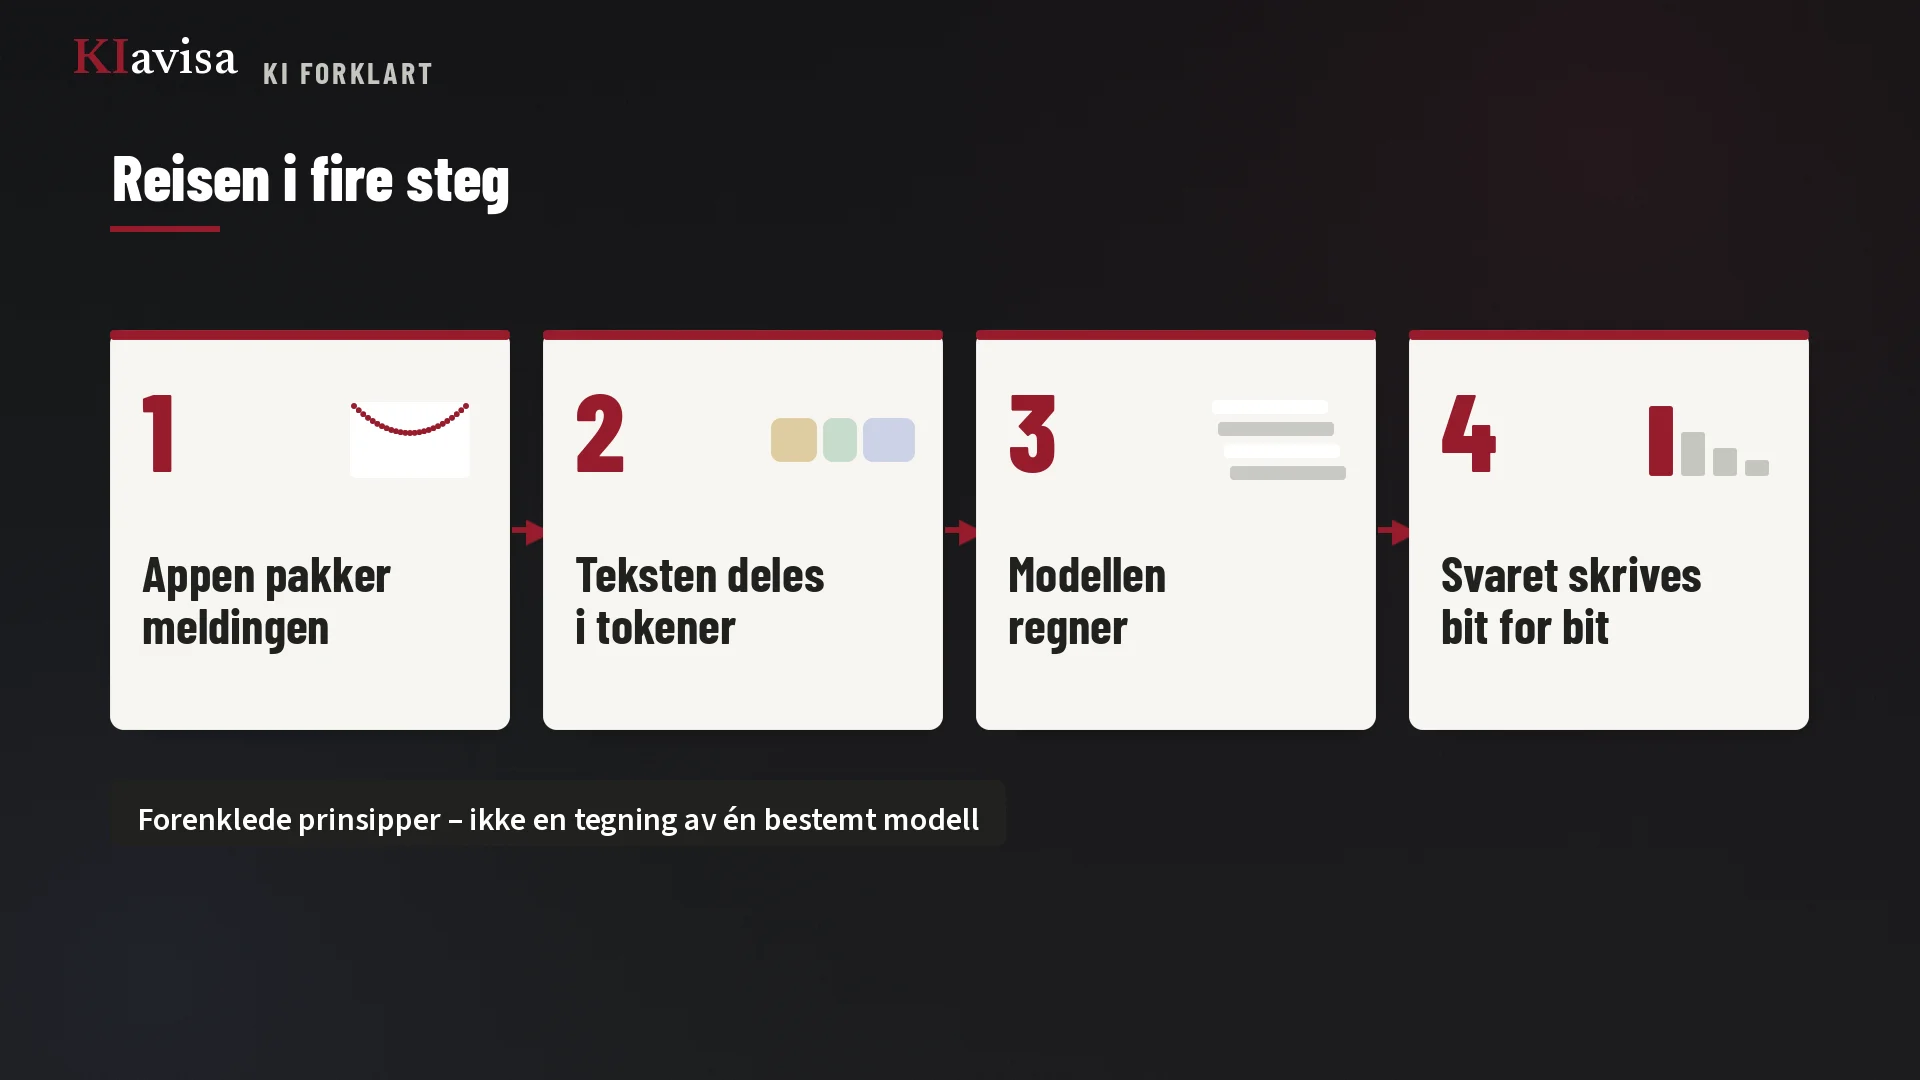
Anthropic beskriver kontekstvinduet som all teksten en språkmodell kan bruke når den lager et svar, også selve svaret. Selskapet kaller det modellens arbeidsminne. Tenk på det som et arbeidsbord. Det som ligger på bordet, kan modellen bruke akkurat nå. Opplysninger fra samtalen din som ikke ligger der, kan den ikke se. Bordet er noe annet enn alt modellen lærte under treningen. Det var en egen, stor tekstsamling, skriver Anthropic. Konteksten er det som er lagt fram for akkurat denne samtalen. Hva ligger så på bordet? I Claude API teller alt i forespørselen med: instruksjoner fra appen, alle meldingene i samtalen, dokumenter, bilder og svar fra verktøy. Og svaret som skrives nå, tar også plass. Men her halter bildet med bordet. Modellen leser ikke teksten slik du leser et ark. Teksten gjøres først om til tall. Og det bringer oss til tokener.
Hugging Face forklarer at modeller bare kan behandle tall. En tokeniserer deler derfor teksten i biter, tokener, og gjør dem om til tall. Bitene kan være hele ord, deler av ord eller tegn. Vanlige ord holdes gjerne hele, mens sjeldne ord deles i meningsfulle deler. Et langt ord som «hasselnøttkake» kan for eksempel bli flere biter. Kontekstvinduet måles i tokener. For de nyeste Claude-modellene oppgir Anthropic opptil én million tokener, avhengig av modell. Vi gjør ingen fast omregning til norske ord. Det kommer an på tokenisereren. Og i en samtale hoper tokenene seg opp. Ifølge Anthropic tas hele samtalehistorikken med i hver ny runde, sammen med den nye meldingen din. Svaret blir så en del av neste runde. Bordet blir fullere for hver melding.
Hva skjer når samtalen nærmer seg grensen? Anthropic skriver at chatgrensesnitt, som selskapets egen chattjeneste, kan styre vinduet rullerende. Det eldste går ut først. Og den aller første meldingen var nettopp: «Mia tåler ikke nøtter.» Faller den utenfor vinduet, er den ikke med når kakeoppskriften skrives. Den kan likevel stå i samtalen du ser på skjermen. Det du ser, og det modellen får med, er ikke nødvendigvis det samme. En annen metode er oppsummering. Anthropic har en funksjon som erstatter eldre deler av samtalen med et sammendrag, slik at samtalen kan fortsette. Men et sammendrag er kortere enn originalen. Anthropic skriver selv at standardsammendraget kan miste noe en senere melding trenger. Og selv om alt får plass, er mer kontekst ikke automatisk bedre. Anthropic skriver at nøyaktigheten, og evnen til å finne igjen opplysninger, svekkes når antallet tokener vokser. Det er leverandørens beskrivelse, ikke noe vi har målt. Hva kan du gjøre? Gjenta det viktige der det trengs: «Kakeoppskrift uten nøtter. Mia er allergisk.» Eller start en ny samtale med de viktigste opplysningene først. Og når det gjelder allergi, sjekk ingrediensene selv.
Noen KI-tjenester kan også huske ting mellom samtaler. Her er det lett å blande begrepene. Lagret minne er ikke det samme som kontekst. Ta Anthropics minneverktøy for utviklere. Der kan Claude lagre opplysninger i filer i en egen minnemappe, og lese dem igjen i senere samtaler. Filene ligger ikke på bordet hele tiden. De hentes fram når de trengs. I eksempelet vårt kunne en slik fil inneholde «Mia: nøtteallergi». Når du spør om kake neste gang, kan filen leses inn på bordet igjen. Først da er opplysningen en del av konteksten. Legg merke til hva som ikke skjer. Modellen trenes ikke på nytt. Den får bare mer tekst på bordet. Anthropic skiller kontekstvinduet fra dataene modellen ble trent på. Og dette er ett konkret verktøy. Minnefunksjoner i ulike chatapper kan virke helt annerledes. Vil du vite hva en app lagrer, må du lese hva leverandøren skriver om akkurat den.
Kort oppsummert. Én: Kontekst er det modellen har på bordet når den svarer, og svaret tar også plass. To: Lange samtaler kan rulleres, oppsummeres eller bli for fulle. Gjenta det viktige. Tre: Lagret minne må hentes inn i konteksten, og det er ikke ny trening. Vil du se hvordan svaret blir til, token for token, har vi en egen video om hva som skjer når du spør ChatGPT. Og i «Hvorfor kan den ta feil?» ser vi på feil som kan skje selv med alt på bordet. Kildene finner du på kiavisa.no. Fortellerstemmen er syntetisk, laget med Gemini-stemmen Charon.